yolo跑通的示例代码
https://github.com/qingyaozhuozhang/jingshen/tree/main/%E6%91%84%E5%83%8F%E5%A4%B4/yolo
模型训练
- 将未标注的图片(训练集和测试集)分别放置在
images文件夹下的train和val,将标注好的图片(训练集和测试集)分别放置在labels文件夹下的train和val
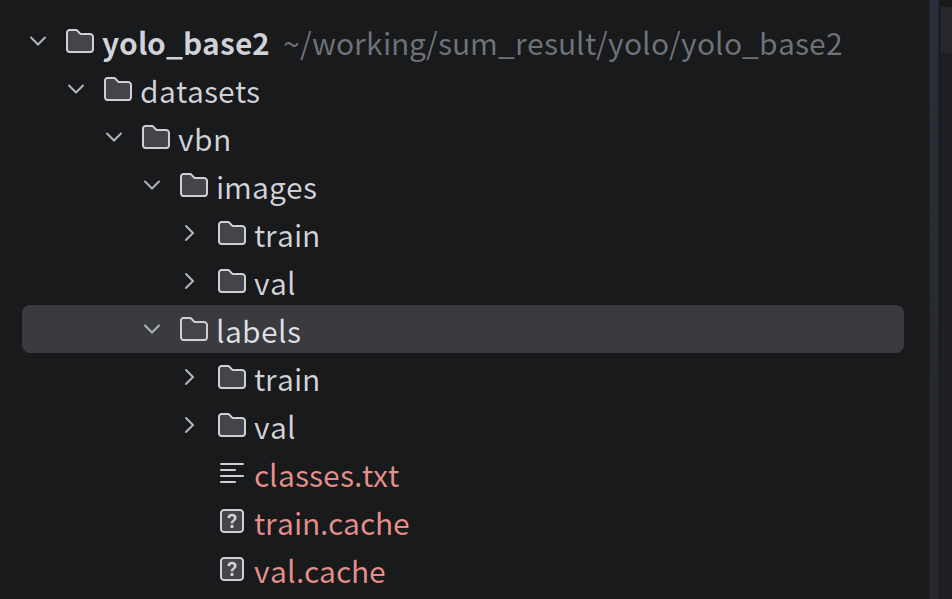
- 找到
yolo-vbn.yaml这个配置文件 - 将未标注图片的路径填写入对应的位置
- 类别格式:
序号(从0开始): 属性名称
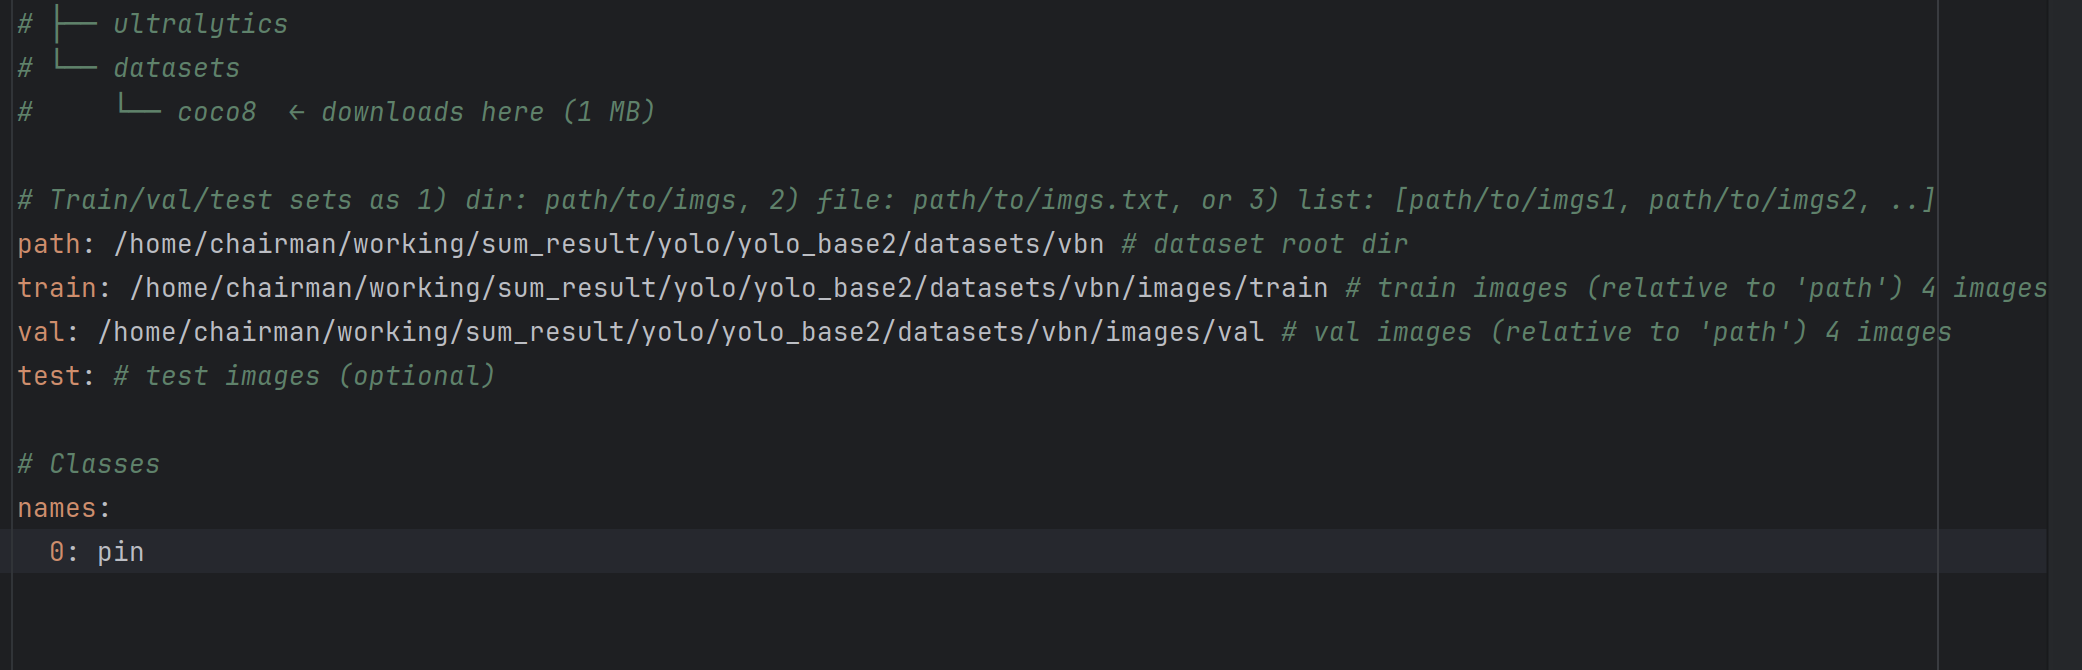
-
然后使用
train.py文件去训练模型 -
参数调节
-
参数名 当前值 / 示例 含义与作用 深度解析 & 建议 data'yolo-vbn.yaml'数据集配置文件路径 指向一个 YAML 文件,该文件核心定义了: 1. 训练集/验证集路径 (path/train/val) 2. 类别数量 (nc) 3. 类别名称 (names) 注意: yolo-vbn是你的自定义文件名,请确保路径正确。workers1数据加载线程数 指定用于 DataLoader预读取数据的 CPU 线程数。 • 当前设置:1较保守,可能导致 GPU 计算完后需等待 CPU 读图(显卡利用率跳变)。 • 建议: - Windows: 设为0或1(多线程在 Win 下常报错)。 - Linux: 建议设为8或cpu核心数,以喂饱 GPU。epochs30训练总轮次 模型完整遍历一次数据集称为 1 个 epoch。 • 当前设置: 30轮属于快速验证或微调。 • 从头训练:建议100-300轮以保证收敛。 • 风险:过少导致欠拟合(学不会),过多导致过拟合(死记硬背)。batch16批次大小 一次性送入 GPU 计算梯度的图片数量。 • 核心制约:显存大小 (VRAM)。 • 大 Batch:训练更快,梯度估算更准(走得稳)。 • 小 Batch:显存占用低,但震荡大,可能有助于跳出局部最优。 • 建议: 16是主流显卡(6G-8G显存)的黄金标准;高端卡可设32或64。device0(默认为空,自动检测)计算设备选择 指定模型运行的硬件设备。 • device=0:使用第 1 块 NVIDIA 显卡(最常用)。 •device=0,1:使用多块显卡进行分布式训练 (DDP)。 •device='cpu':强制使用 CPU(极慢,仅用于调试)。 •device='mps':使用 Mac (M1/M2/M3) 的 GPU 加速。 注意:如果不设置,代码会自动优先寻找可用的 GPU。 -
model.train(data='yolo-vbn.yaml', workers=1, epochs=30, batch=16, device=0)
-
-
训练好的结果会在
runs文件夹中显示 -
具体指标理解
-
1. Confusion Matrix (混淆矩阵)
以矩阵形式将数据集中的记录按照“真实的类别”与“分类模型预测的类别”两个标准进行汇总。
- 行:表示真实值 (True Label)
- 列:表示预测值 (Predicted Label)
#### 2. F1_curve.png
精确率和召回率的调和平均数,用于综合评估模型性能。
#### 3. P_curve.png
准确率 (Precision) 和置信度 (Confidence) 的关系图。
#### 4. arg.yaml
记录了训练时的超参数以及
train.py运行过程中的中间参数。#### 5. PR_curve.png
准确率 (Precision) 和召回率 (Recall) 的关系图。通常面积越大(越靠近右上角)效果越好。
#### 6. R_curve.png
召回率 (Recall) 和置信度 (Confidence) 的关系图。
#### 7. results.png (综合结果)
包含以下关键指标:
- box: 推测损失函数均值 (Box Loss)。
- cls: 目标检测分类损失均值 (Class Loss)。
- dfl: 目标检测边界框回归精度的损失函数均值 (Distribution Focal Loss)。
- precision: 精度 (查准率)。
- recall: 召回率 (查全率)。
- mAP: 使用 Precision 和 Recall 作图后围成的面积,m 表示平均 (mean)。
💡 Loss 分析注意事项:
- cls_loss: 当分类损失
< 0.1时,模型分类效果较好。 - box_loss: 当数值在
0.01 - 0.1之间时,位置回归效果较好。
-
-
训练好的模型在
runs中的weights文件夹下
训练模型的调用
-
example.py -
显示检测结果
-
onnx.py -
将训练后的模型格式
pt转成onnx(可以更广泛地被调用)
注意事项
- 不能只对一张图片进行训练,会“失效”
- 至少要找20张图片
提高阶段
roboflow规范和增加数据集
- 自己标注一部分数据集之后到
roboflow去增加规范数据集格式以及增加数量 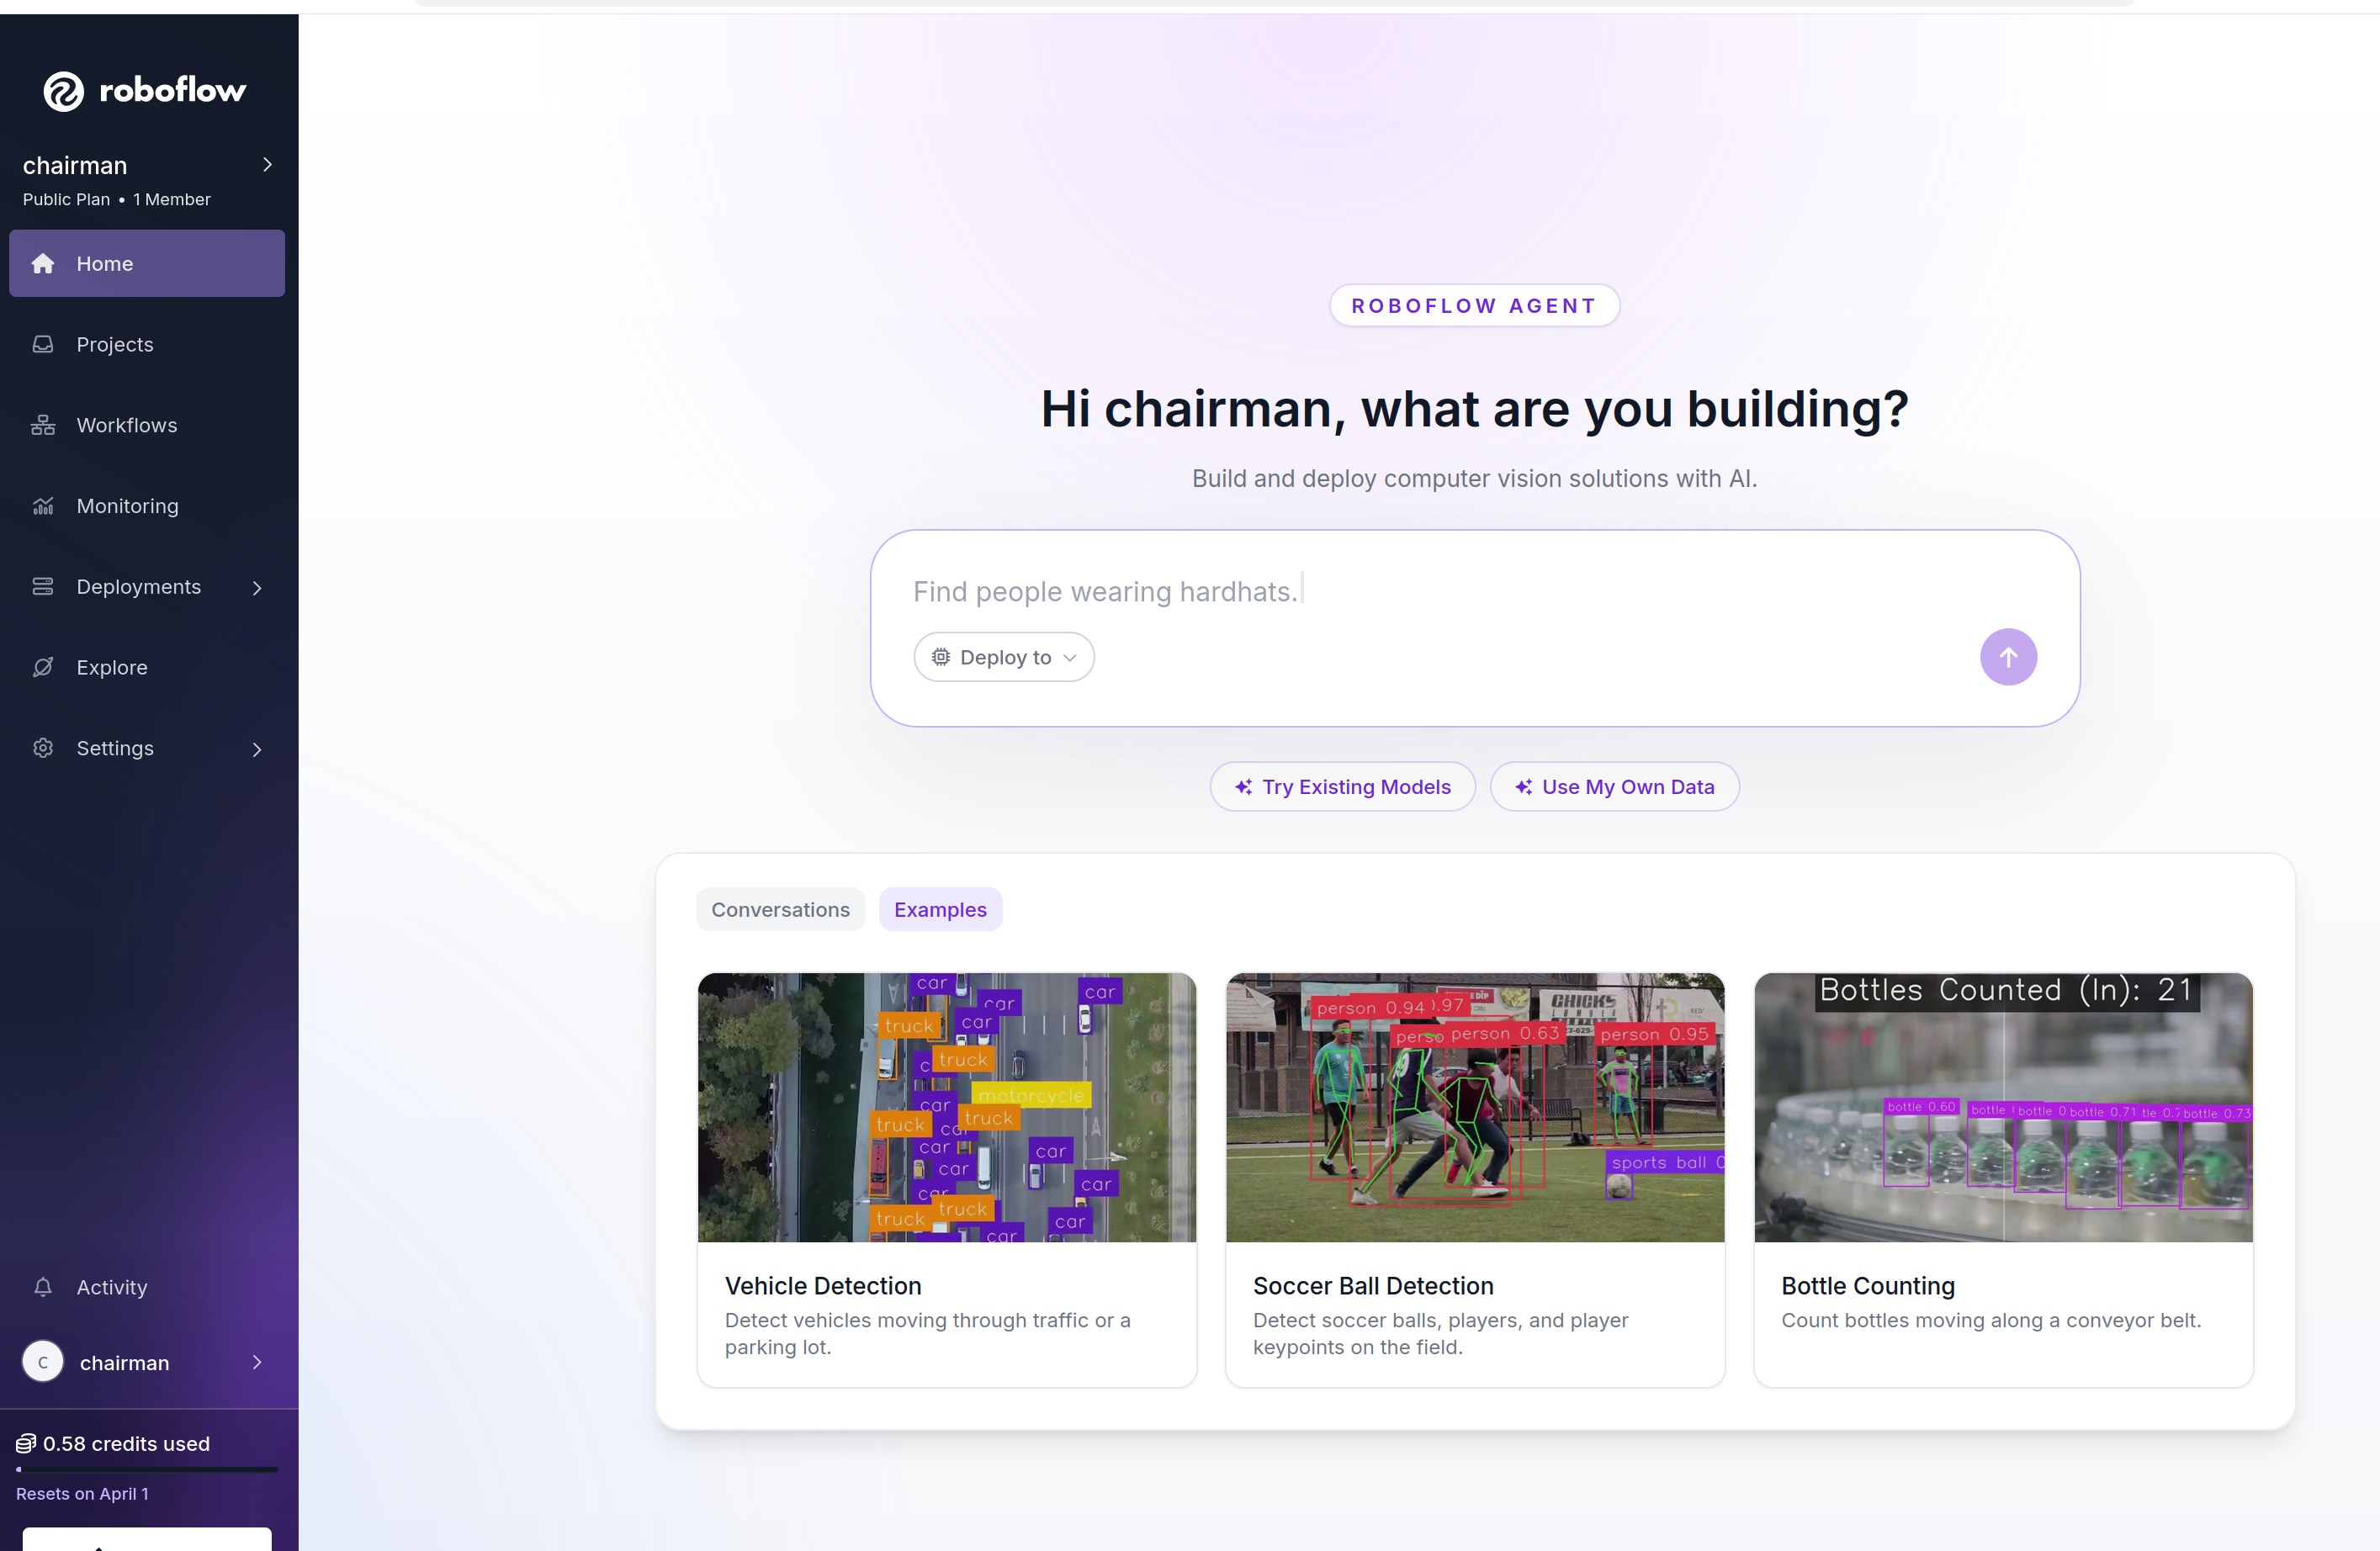
- 选择
Projects然后点击右上角的New Project 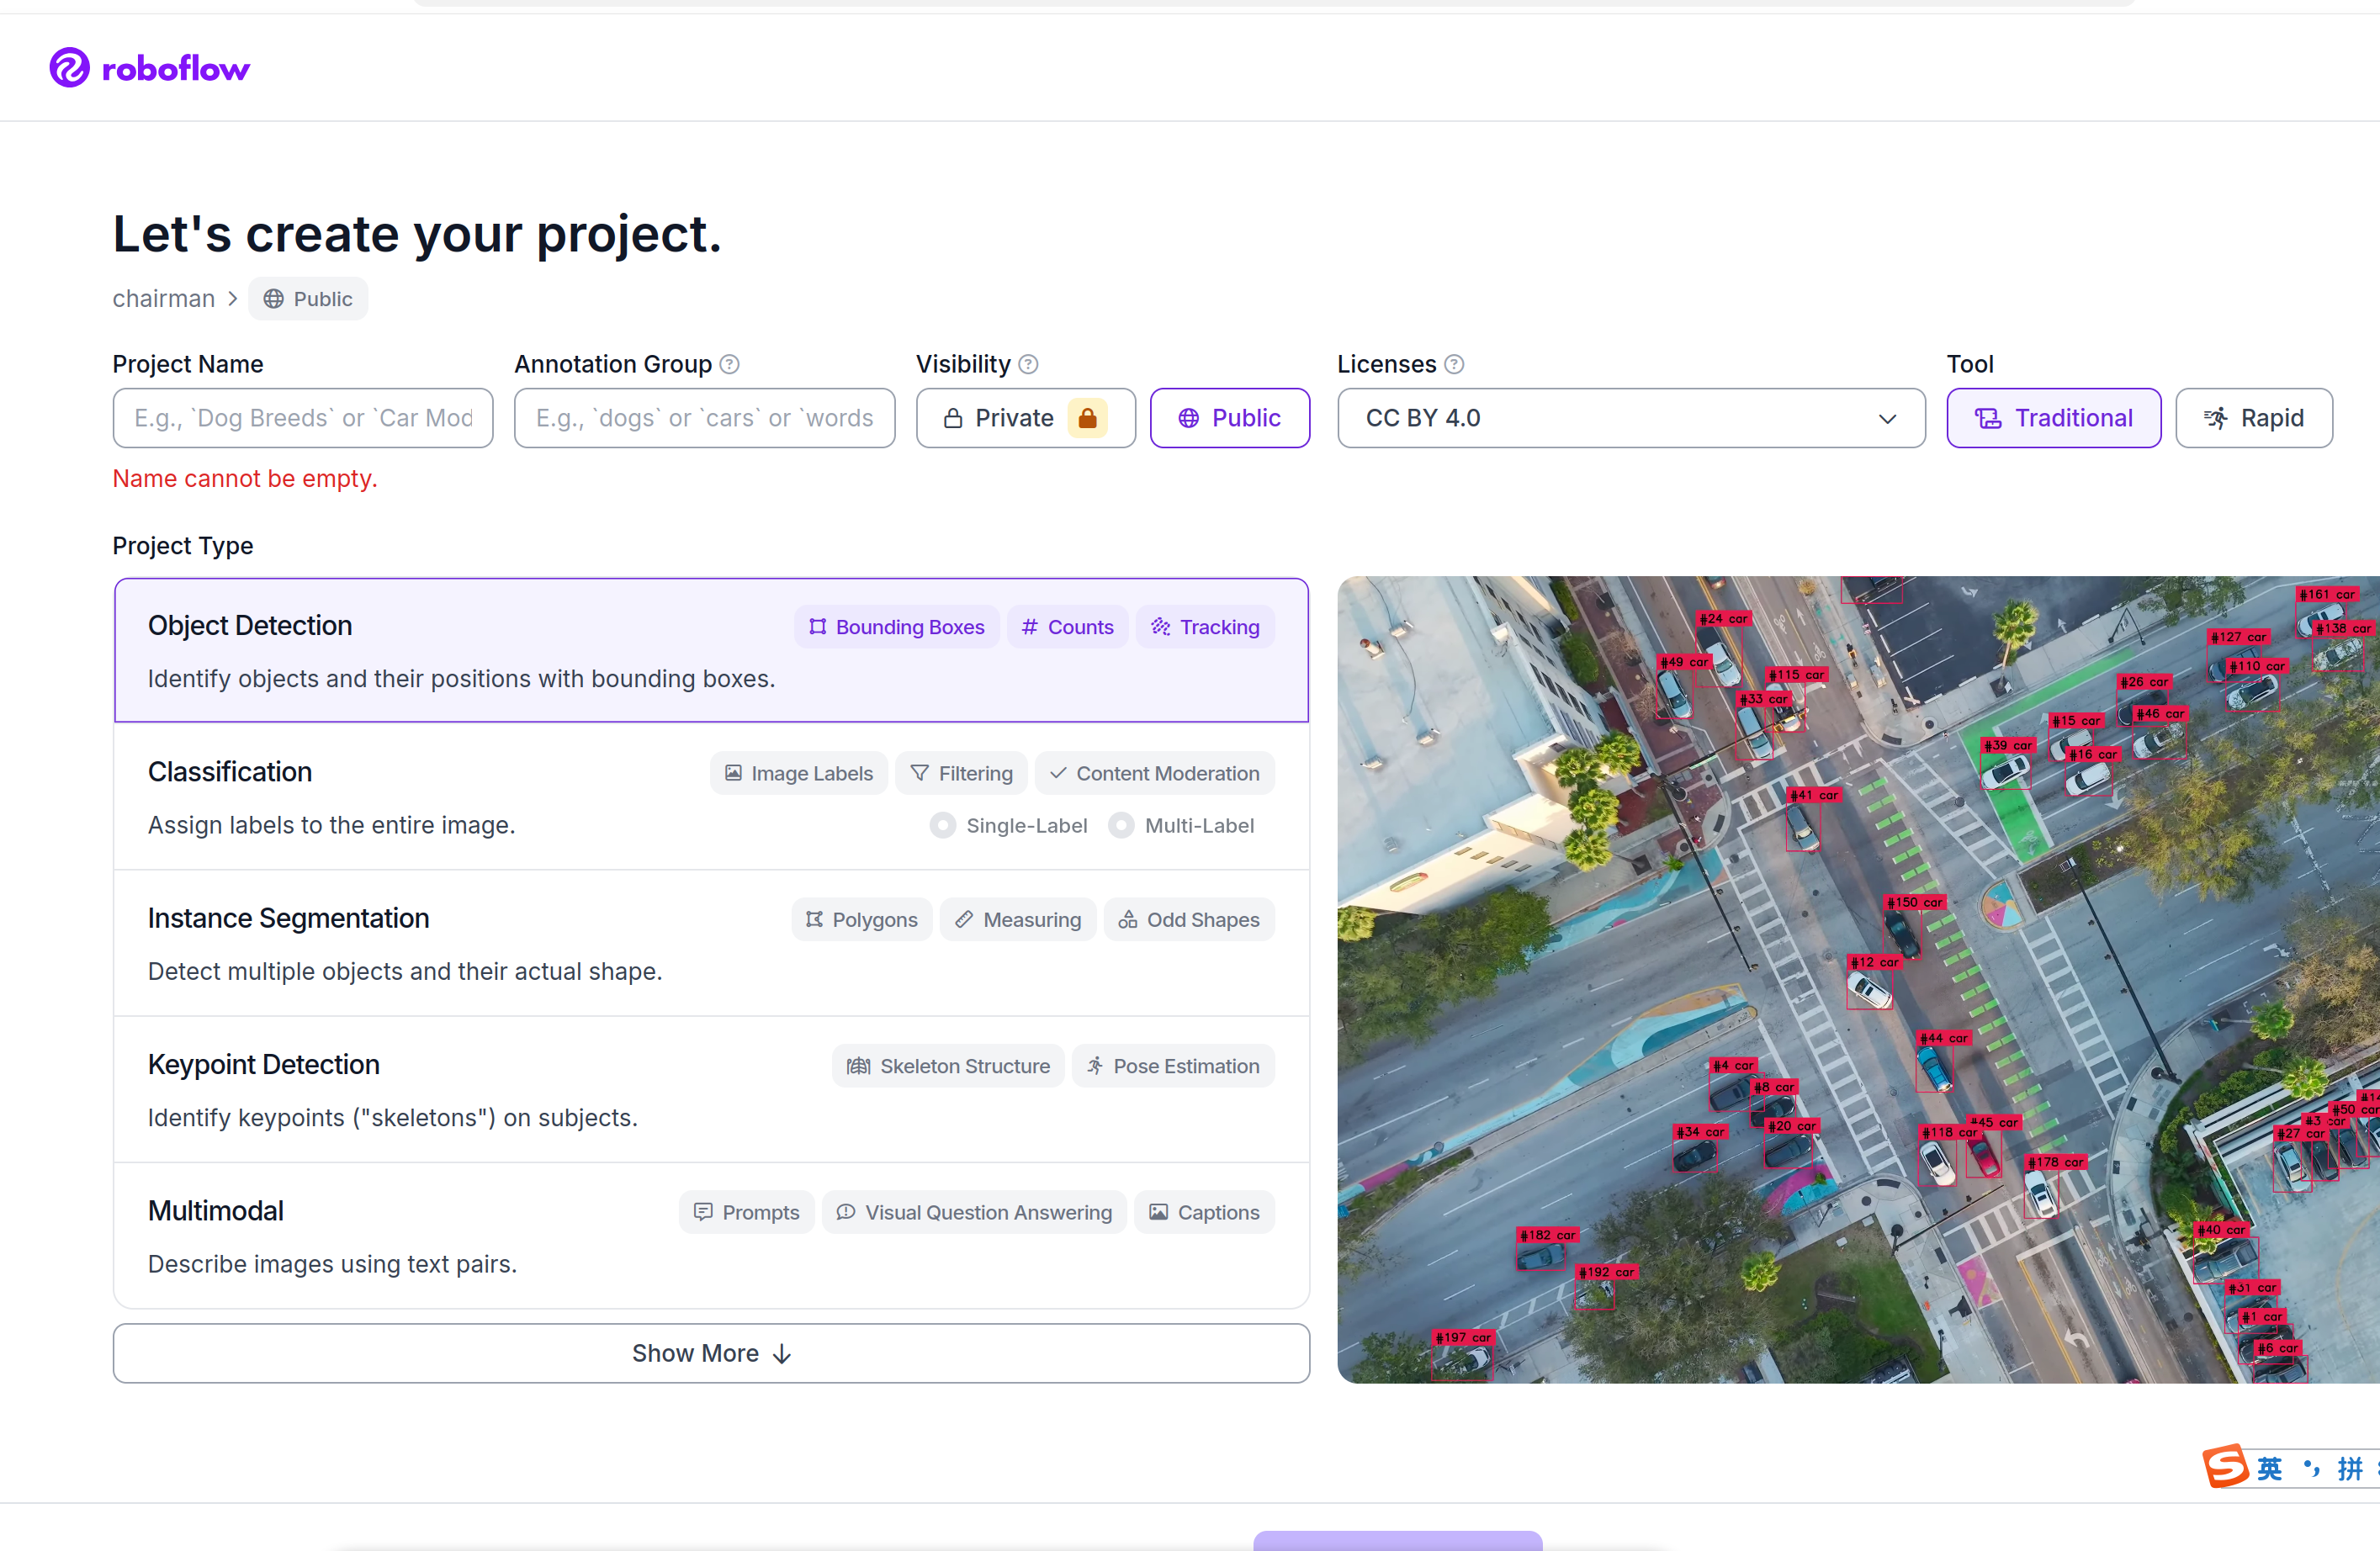
- 选择
Object Detection然后填入Project Name,完成后会自动帮你将图片以及标注信息分类好 - 完成后点击
Versions 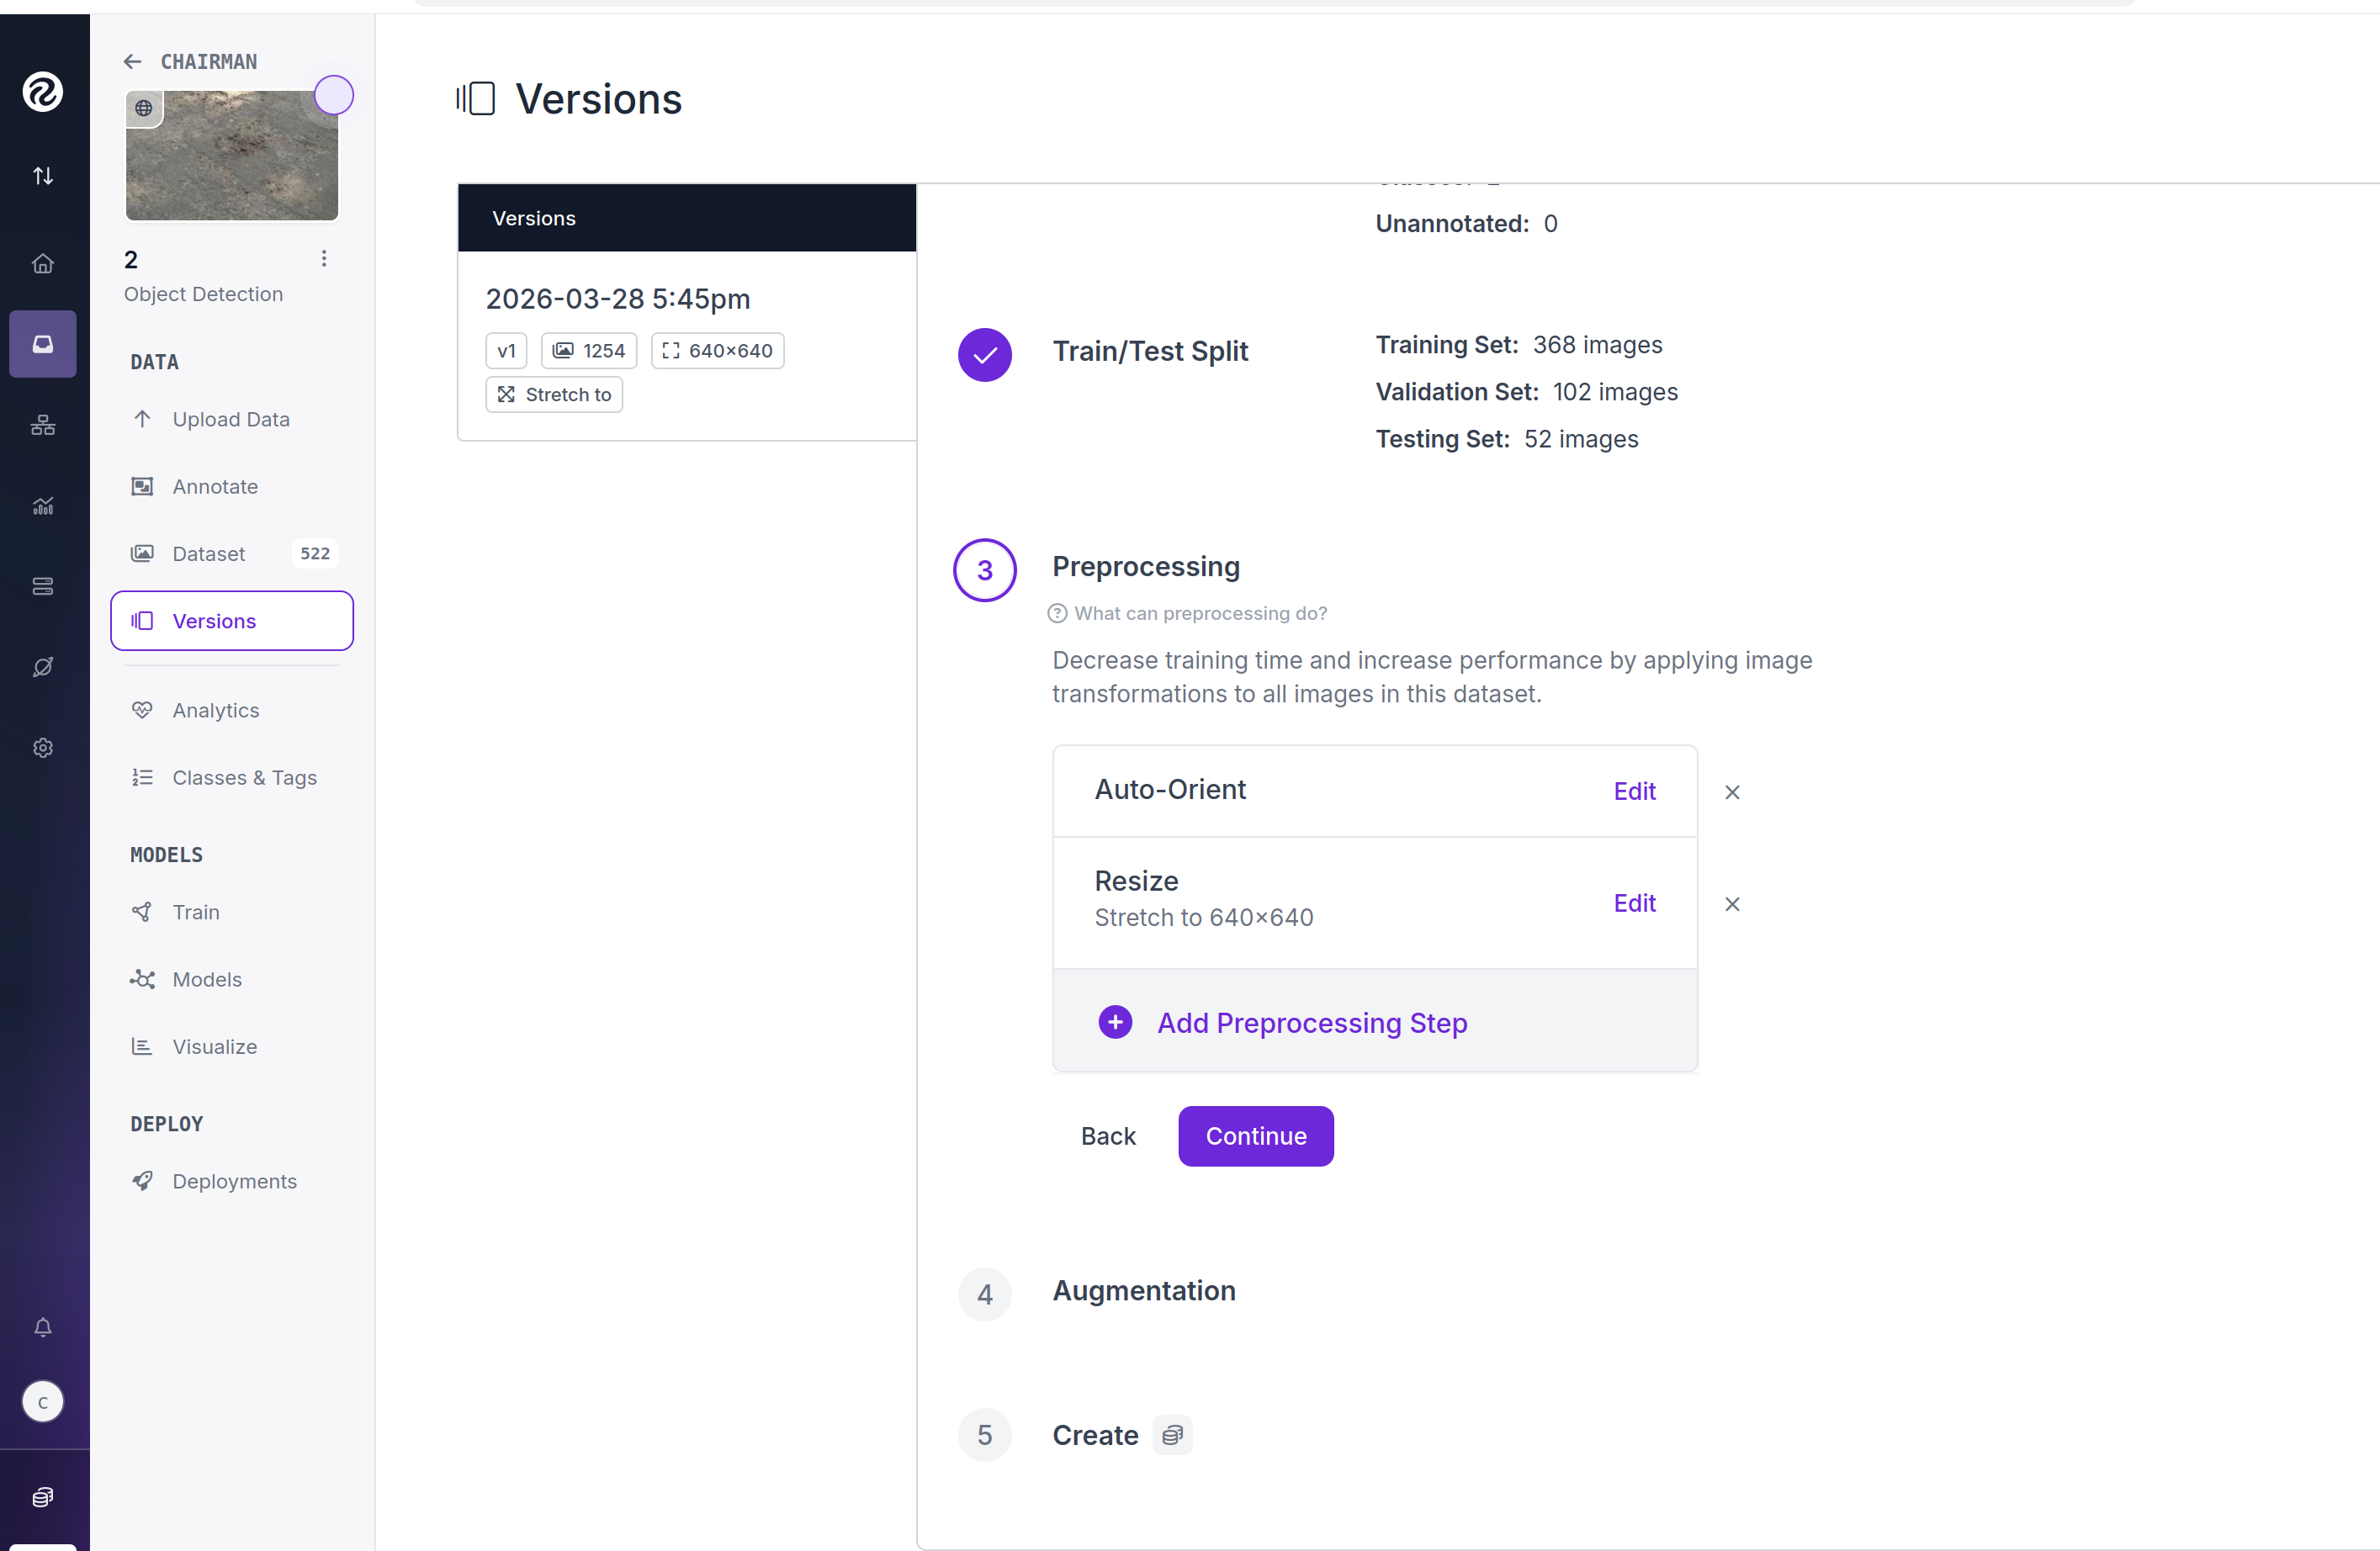
Resize选择640 x 640- 在
Augmentation中选择Flip和Rotation(默认的正负15°),接着正常生成就行 - 生成完成后直接
DownloadDownload zip to computer是下载到本地Show download code是下载到服务器
服务器训练数据集
https://colab.research.google.com/github/Yogender-Singh/Notebooks/blob/main/yolo-series/tutorial.ipynb#scrollTo=1NcFxRcFdJ_O
-
先到页面右上角点击连接GPU
-
到终端粘贴
roboflow的命令行 - 运行
Setup中的命令行(配置服务器环境) 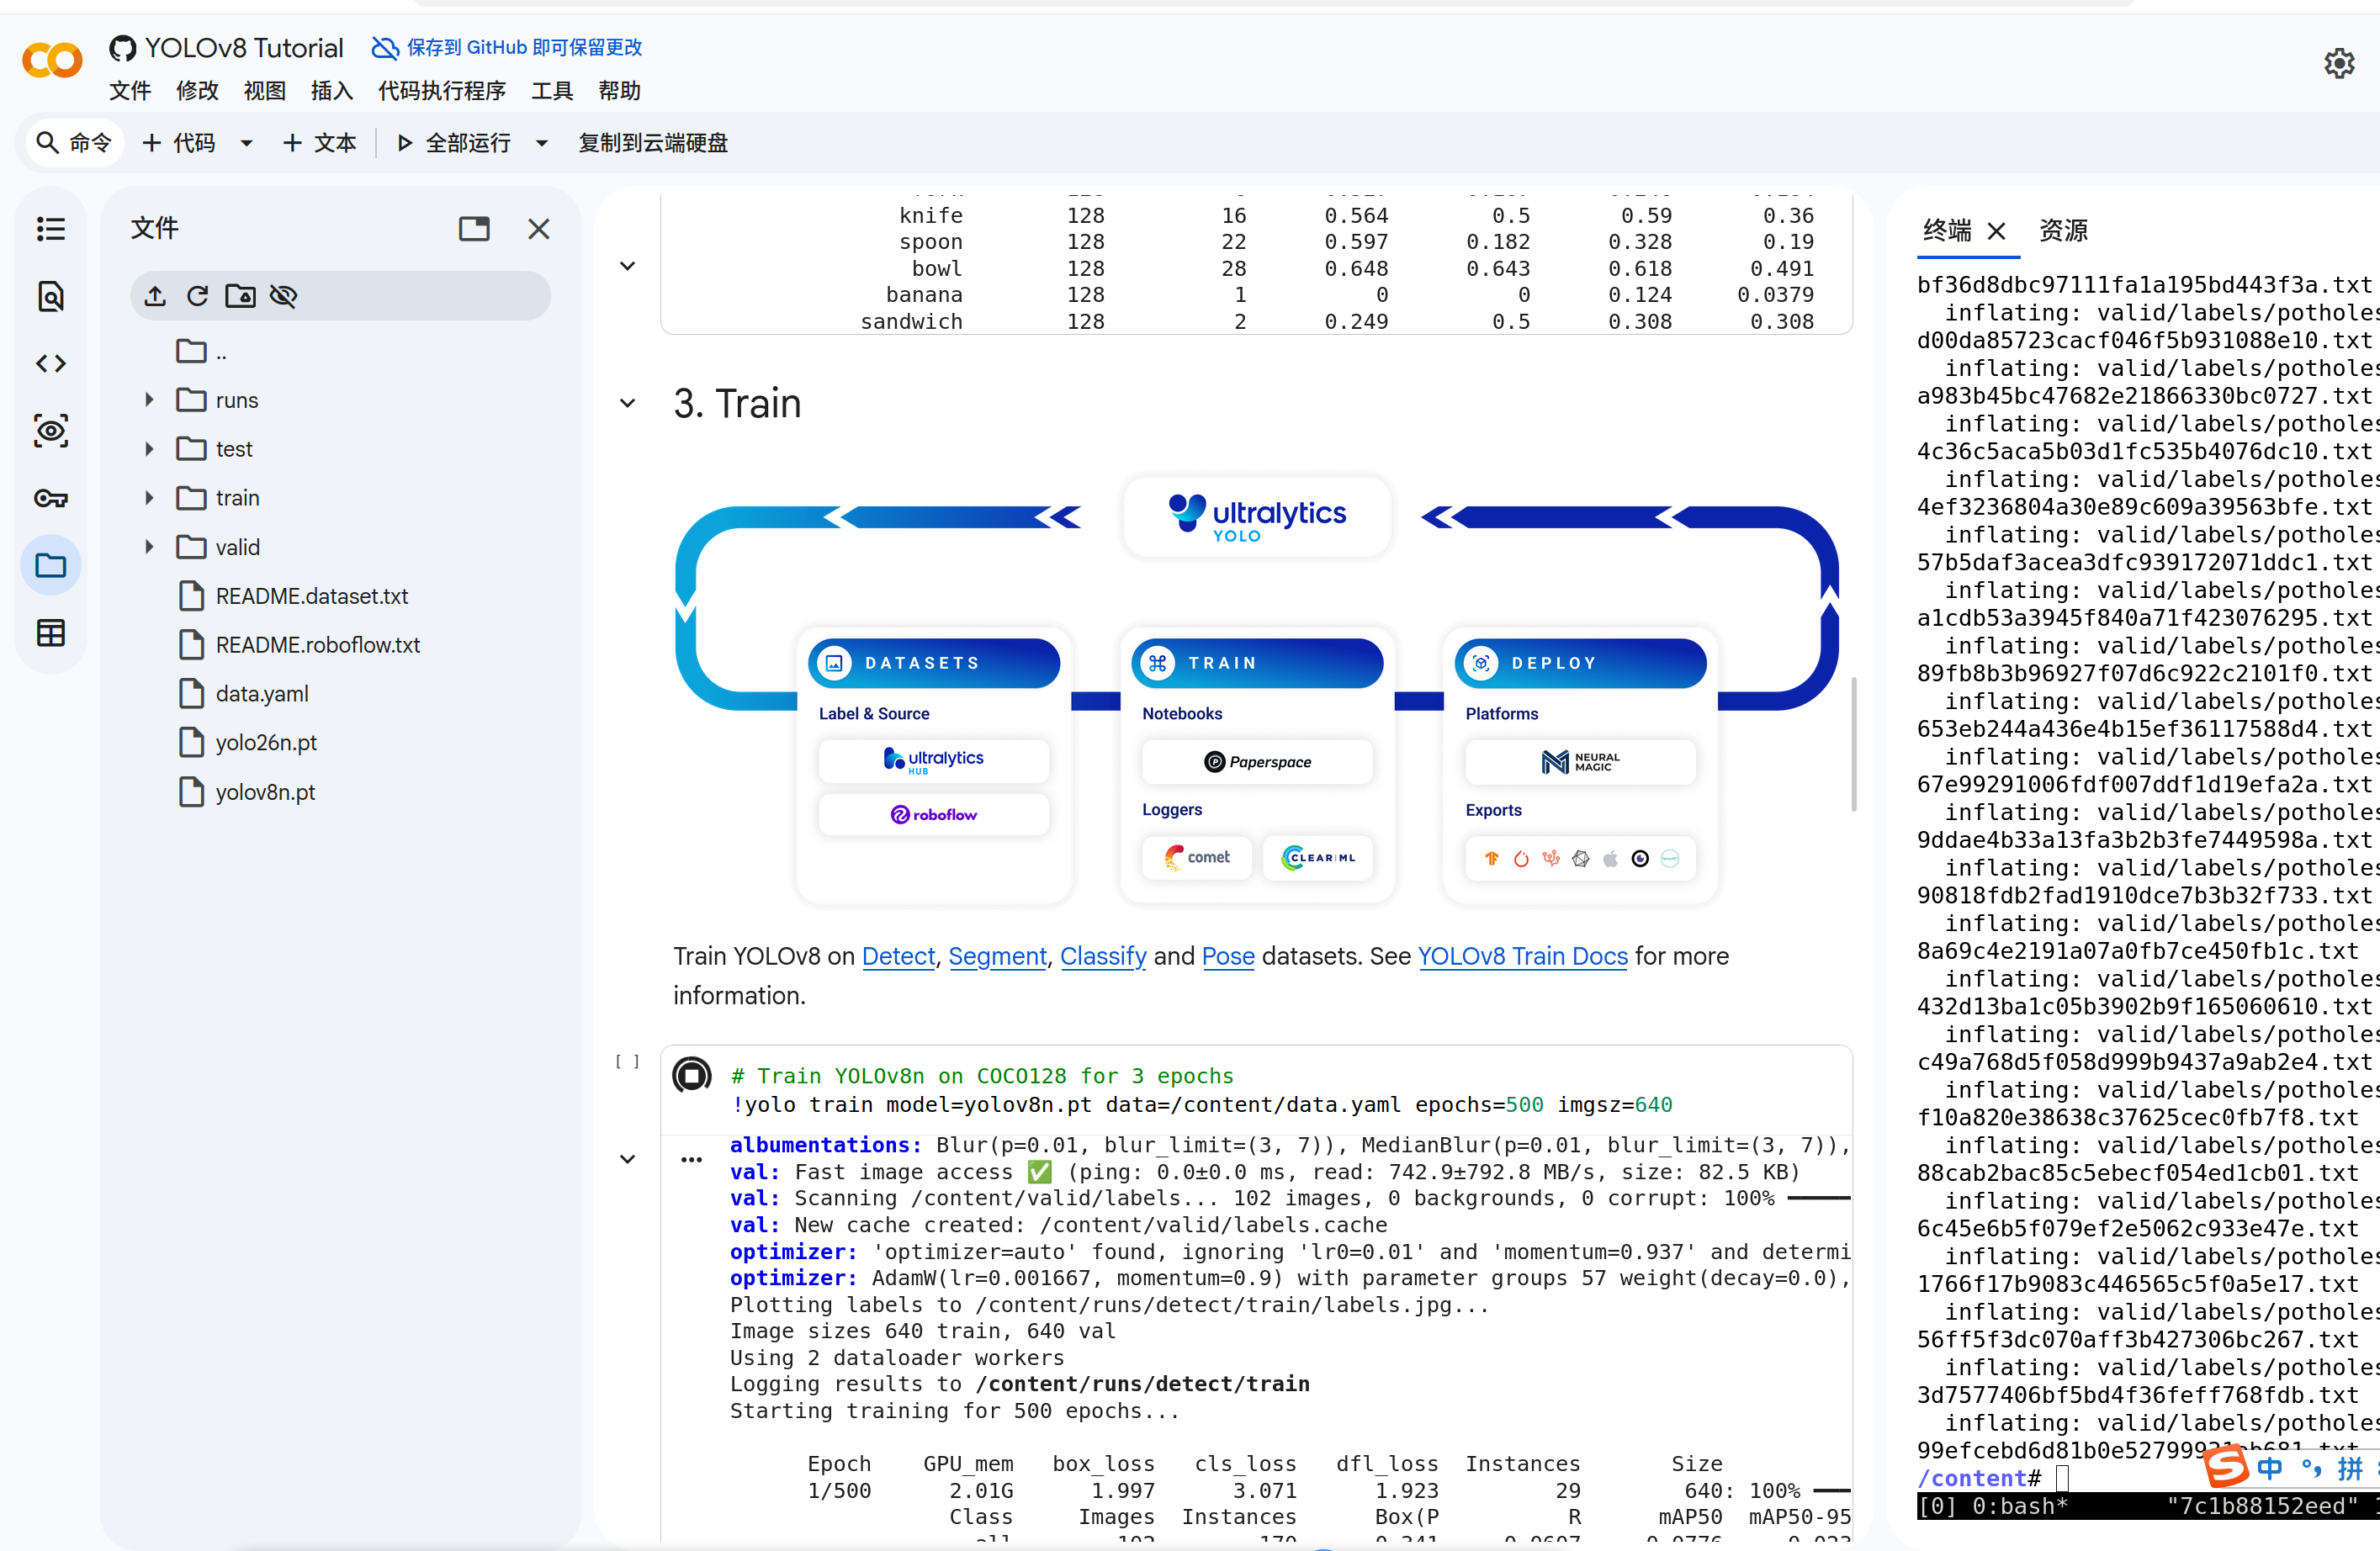
- 到
Train中复制左侧栏目中的data.yaml路径粘贴到命令行中data的位置,然后选择训练轮次(epoch),开始运行程序 - 训练出来的损失率越接近1越好,
mAP>=0.7和mAP0.5~mAP0.95>=0.5 - 下载整个文件夹
- 在终端中输入
zip -r download.zip /content/your_folder - 然后像下载文件一样下载下来
AI辅助标注
-
-
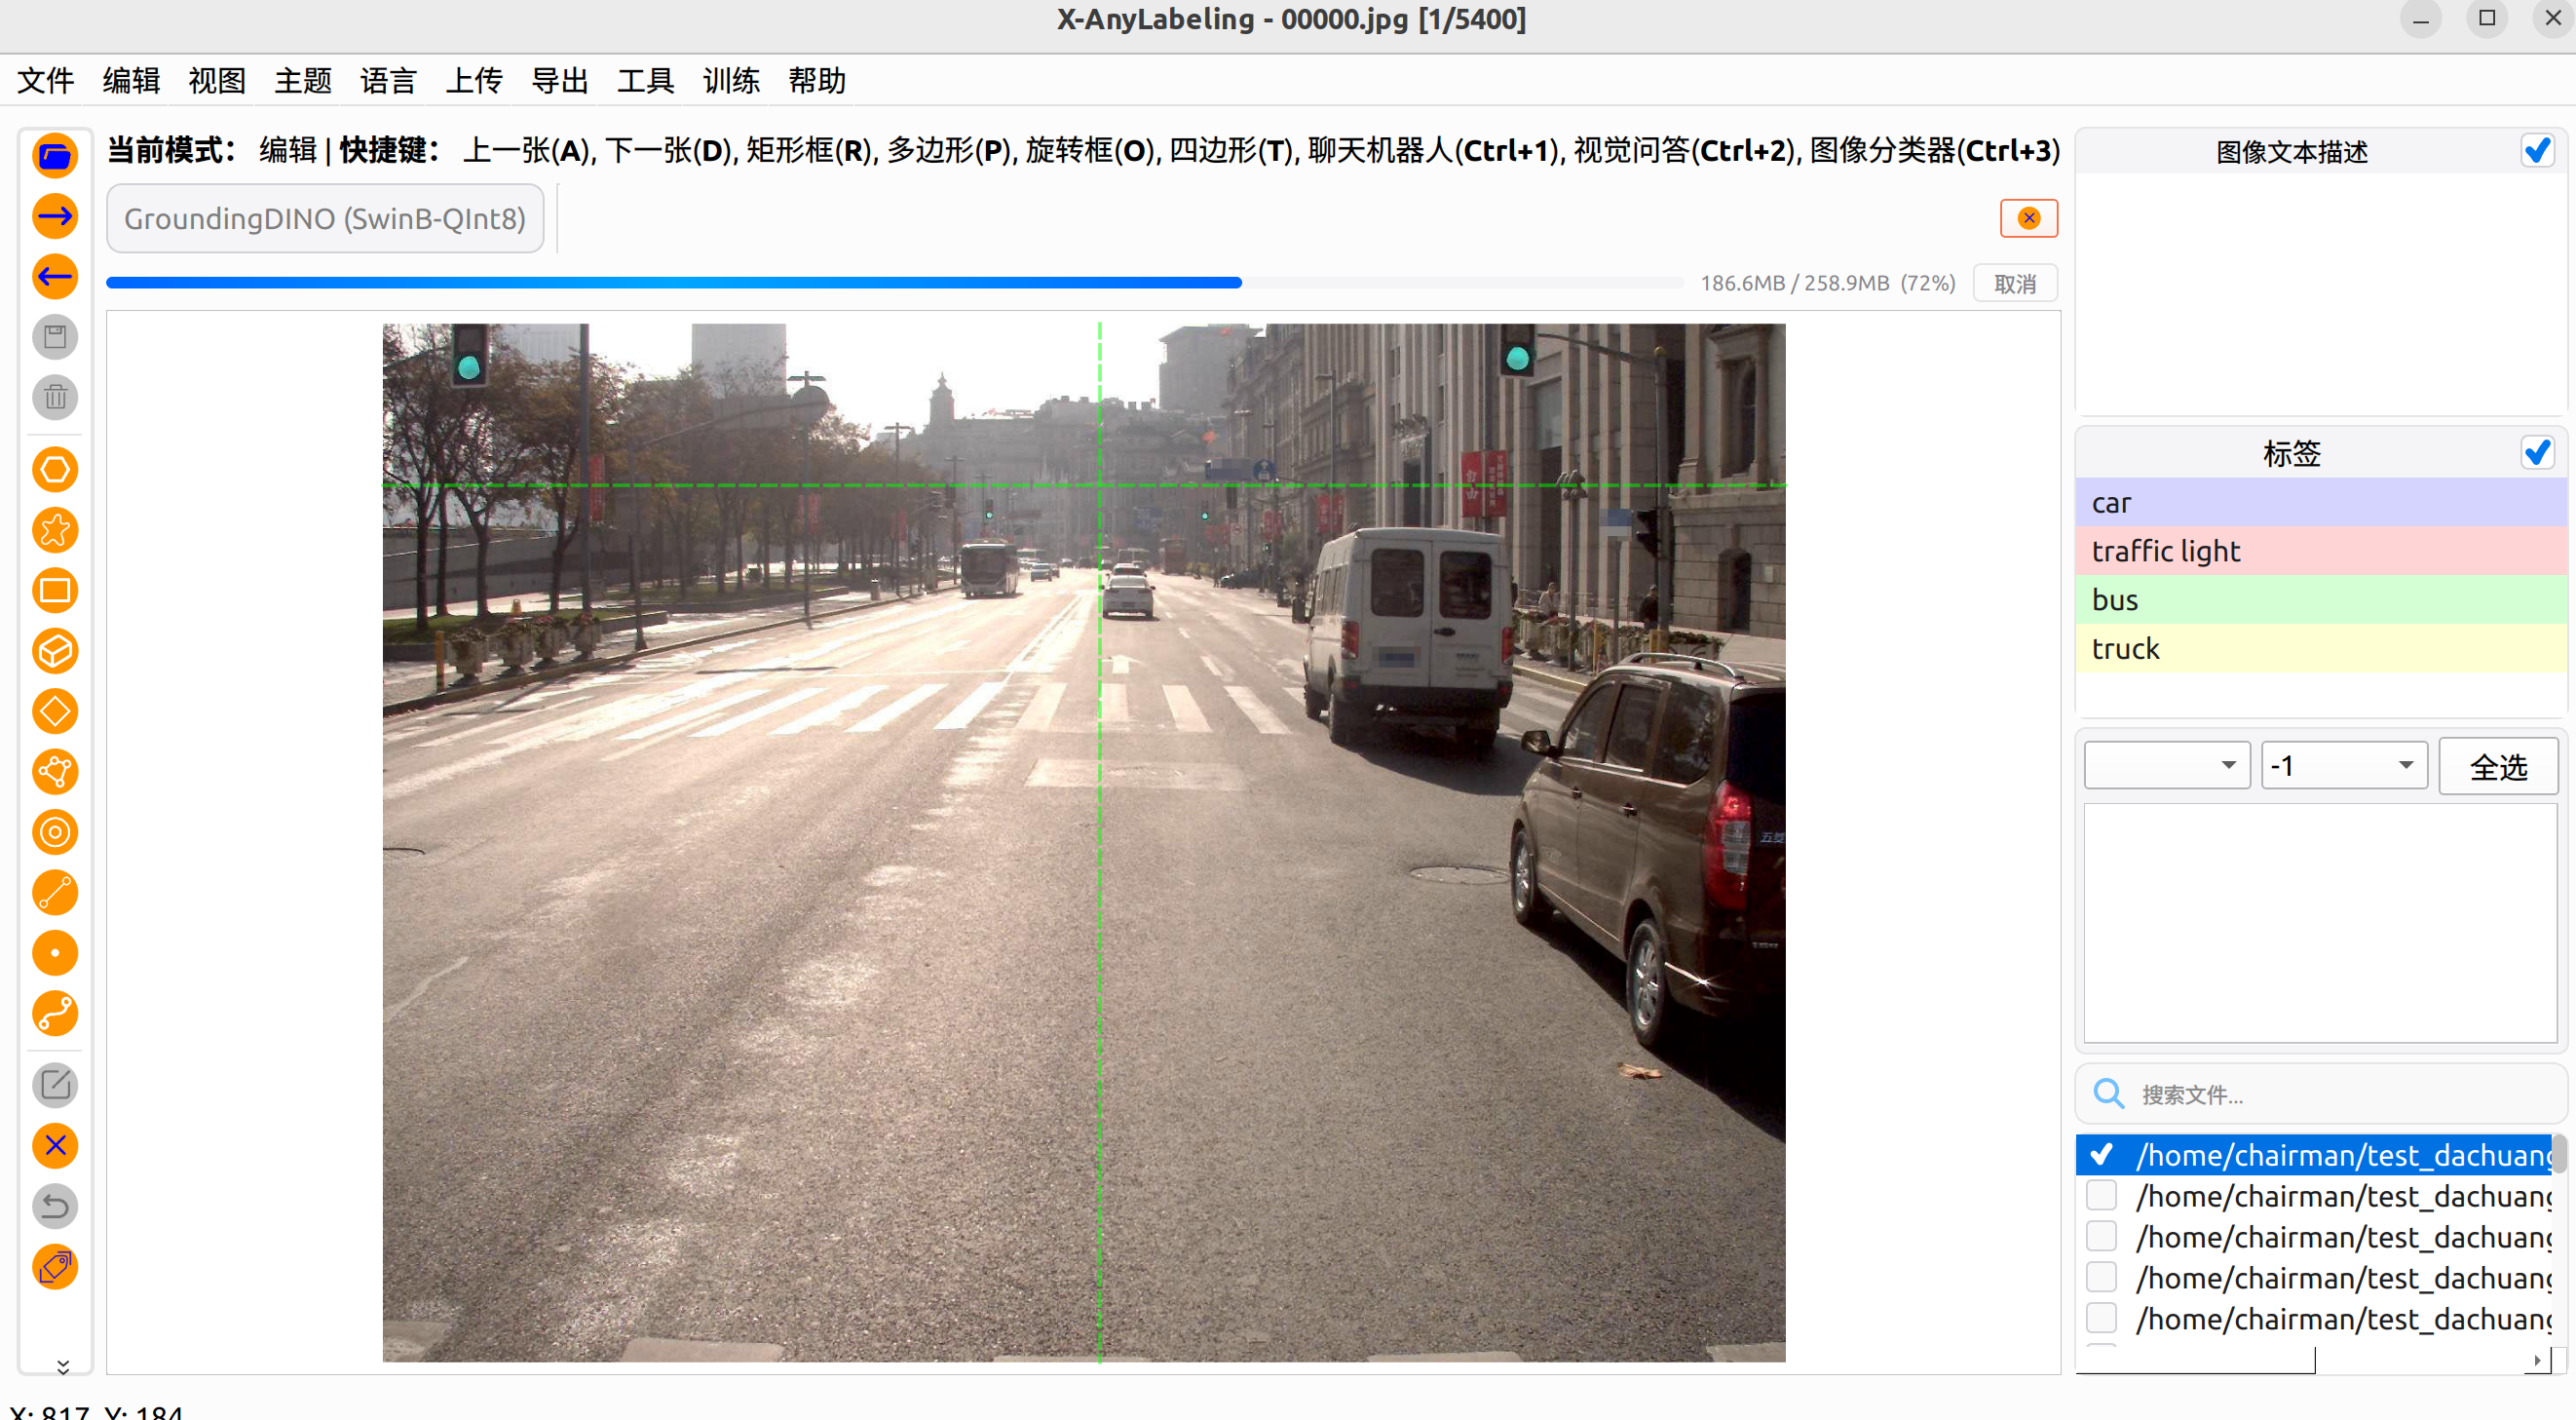
选择
GroundingDINO(SwinB-QInt8),在框内输入文本内容就能自动识别 - 多个文本信息就使用
.来隔开,示例:crack.pothole. - 使用自己模型就选择
..load_custom_model,然后选择自己的classes.txt